Un apel video are ceva pe care de mult timp am considerat aproape de la sine înțeles: dacă vedem pe cineva reacționând la ceea ce spunem, ne întrerupe, zâmbește la momentul potrivit sau ne uităm la ceea ce tocmai am arătat cu camera, presupunem că există o persoană de cealaltă parte. Inteligența artificială complică această certitudine de ani de zile cu voci clonate și videoclipuri sintetice, dar menținerea acestei interacțiuni live este o altă poveste. Și tocmai aici a apărut un model care își propune să ștergă o bună parte din acea distanță.
Modelul respectiv se numește Griffin, deși versiunea la care Tavus a supus-o acestor teste este Versiune de cercetare Griffin-Lite. Cel mai izbitor rezultat al acestuia provine dintr-un experiment efectuat cu 54 de participanți: după ce au discutat un minut cu sistemul, 26 dintre ei, 48%, au spus că au crezut că interlocutorul lor a fost o persoană reală. Compania susține că acest rezultat face din Griffin primul model capabil să treacă un „test video Turing” în timp real. Declarația, totuși, are nevoie de mult context.
Ce înseamnă cu adevărat să treci un test Turing pe video
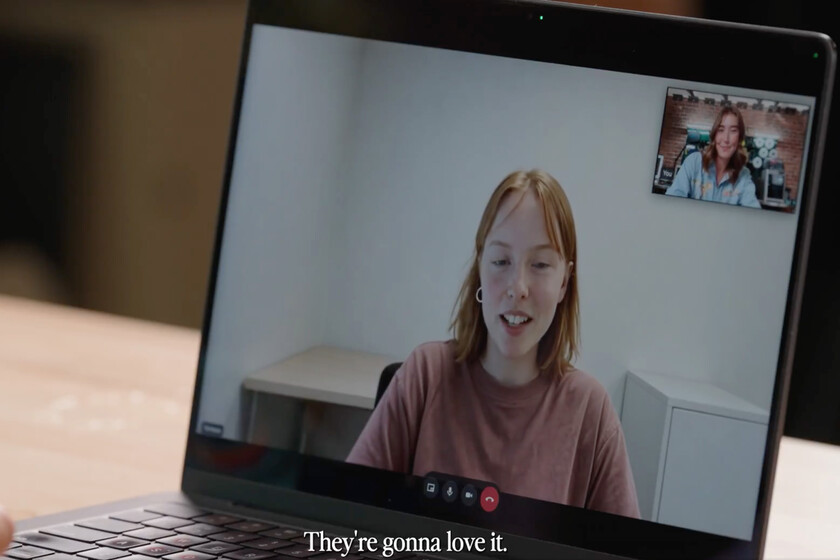
Cheia constă în modul în care a fost configurat experimentul. Cei 54 de participanți, recrutați printr-o platformă independentă de cercetare, au crezut că vor vorbi timp de un minut cu o altă persoană despre ceea ce așteaptă cu nerăbdare în acest an. Pe cealaltă parte era Griffin-Lite, generand conversația și prezența audiovizuală live. Nu li s-a cerut de la început să facă distincția între om și IA: acea întrebare a apărut abia la sfârșit, după ce s-au evaluat aspecte precum naturalețea, încrederea și fluența. Dintre cei 54, 26 au spus că cred că interlocutorul lor este real; Într-un test echivalent cu sistemul anterior al companiei, doar 1 din 41 a răspuns la fel. Recrutarea a fost efectuată printr-o platformă independentă, dar testul și rezultatele sale au fost publicate chiar de Tavus.
Aici apare prima nuanță majoră. Abordarea publicată de Alan Turing în 1950, din care provine testul care astăzi îi poartă numele, nu includea chipuri, voci sau apeluri video: comunicarea trebuia făcută în scris, tocmai decizia interogatorului nu ar condiționa nicio decizie fizică. De asemenea, nu există un singur protocol recunoscut care să funcționeze ca „testul” Video Turing. Termenul fusese deja folosit în cercetări înainte de Griffin: în 2023, de exemplu, o lucrare publicată în AI Magazine a prezentat un test sub acest nume menit să evalueze măsura în care o IA ar putea înțelege videoclipurile într-un mod comparabil cu un om. Tavus aplică ideea de indistinguire la un experiment diferit, bazat pe o conversație audiovizuală față în față.
Există, de asemenea, un precedent foarte recent pentru un test Turing cu trei participanți. Un studiu publicat în PNAS în mai 2026 a pus fiecare interogator să converseze timp de cinci minute, în scris și simultan, cu o persoană și un model înainte de a decide care dintre cei doi era uman. GPT-4.5, când i s-au primit instrucțiuni suplimentare pentru a adopta o personalitate umană, a fost aleasă ca persoană 73% din timp. Cu același model în condiția fără acel bloc de instrucțiuni de personalitate, cifra a rămas la 36%. Rezultatele nu sunt direct comparabile cu cele ale lui Griffin deoarece protocoalele sunt diferite: noutatea pe care o susține Tavus este în a transfera această confuzie într-o interacțiune audiovizuală live.
 Griffin-Lite menține conversațiile audiovizuale în timp real și generează chip, voce și răspunsuri din mers | Imagine: Tavus
Diferența este modul în care funcționează Griffin-Lite. Sistemul nu așteaptă pur și simplu ca noi să terminăm de vorbit pentru a începe să reacționăm, ci a fost conceput ca un model full-duplex: în timp ce generează voce și video, continuă să asculte și să observe și reevaluează conversația la intervale de mai puțin de o secundă. Acest lucru vă permite să dați din cap în timp ce vorbim, să interpretați o pauză fără să o confundați automat cu sfârșitul rândului nostru, să vă lăsați întrerupt sau să reacționați la ceva ce arătăm pe camera. Vocea, chipul, privirea și gesturile sunt, de asemenea, generate din aceleași decizii conversaționale.
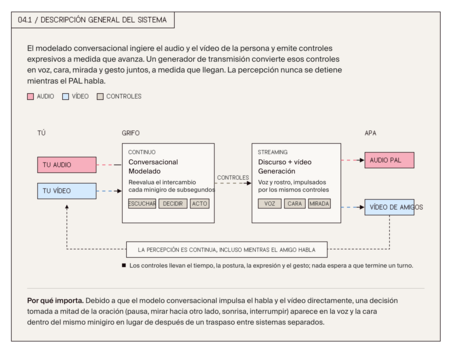 Așa funcționează arhitectura conversațională full-duplex a lui Griffin-Lite, potrivit Tavus (graficul original în engleză a fost tradus în spaniolă) | Imagine: Tavus
Cu toate acestea, avem o referință externă pentru a verifica aceste capabilități. NVIDIA include Griffin-Lite în VideoFDB, un etalon bazat pe 237 de fragmente de apeluri video reale și 11 dinamici conversaționale. Rubricile sale sunt punctate de la 0 la 5 de către un judecător pe baza unui model lingvistic, iar Griffin-Lite conduce în prezent tabelele publicate pentru percepție, cu 3,73 față de 4,20 pentru referința umană și generație, cu 3,83 față de 3,92. NVIDIA subliniază, totuși, că sistemele evaluate rămân sub referința umană în natura conversațională.
De asemenea, toate acestea nu înseamnă că putem intra în Tavus astăzi și că Griffin ne preia apelurile video. Compania comercializează deja o platformă pentru a crea așa-numitele PAL, agenți audiovizuali care pot fi integrați în produse prin intermediul API-urilor, construite fără cod cu PAL Maker sau dezvoltate ca soluții de afaceri personalizate. Îi direcționează către utilizări precum vânzări, instruire sau servicii pentru clienți. Griffin-Lite ocupă un alt loc deocamdată: este încă o versiune de cercetare disponibilă doar unui grup de testeri selectați și Tavus nu o oferă încă clienților săi. Compania asigură că o versiune mai puternică a lui Griffin va ajunge mai târziu.
Și apare și cealaltă fața a facerii unei IA atât de convingătoare. Tavus recunoaște că aceleași caracteristici care permit o interacțiune mai naturală pot, de asemenea, să facă pe cineva să creadă că nu vorbește cu un AI și spune că lucrează la funcții de avertizare pentru a aborda acest risc înainte de a extinde lansarea. Politica sa actuală necesită consimțământ explicit și informat pentru a crea o copie cu imaginea sau vocea unei persoane și necesită raportare clară atunci când cineva interacționează cu conținutul generat sau cu un agent AI. În UE, în plus, Legea AI impune începând cu 2 august 2026 ca sistemele concepute să interacționeze direct cu oamenii să îi informeze că vorbesc cu o IA, cu excepția cazului în care este evident în circumstanțe.
Imagini | Tavus
În investigația noastră tehnică | Legea lui Moore este scurtă: costul AI scade de șase ori mai repede decât cel al calculului clasic