Vânturi noi bat în industria PC-urilor și laptopurilor. După decenii de dominație imperială a arhitecturii x86, Nvidia vrea să schimbe situația cu noile sale cipuri ARM, RTX Spark. El a avertizat de multă vreme despre intențiile sale, iar ambiția respectivă s-a cristalizat în sfârșit.
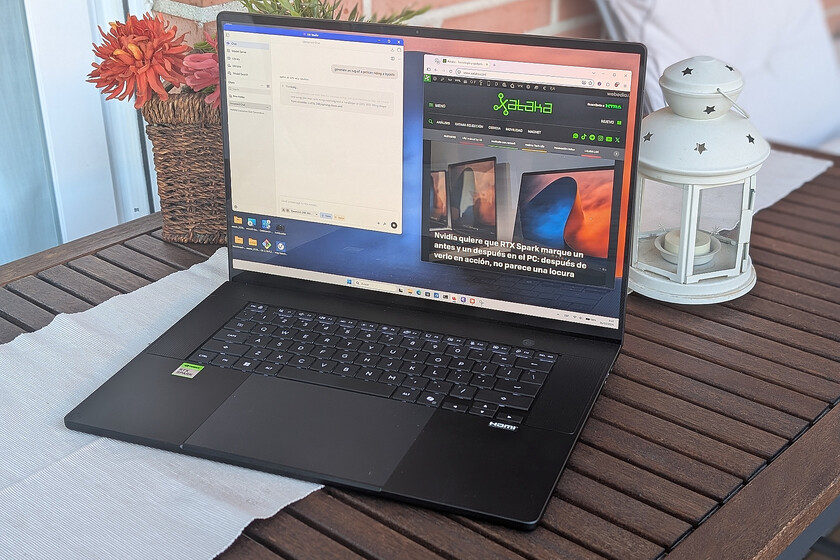
A făcut acest lucru cu primul echipament bazat pe aceste SoC-uri, care provoacă status quo-ul segmentului și, de asemenea, o fac cu o propunere cât mai completă. Am putut să-l vedem direct în aceste zile, pentru că am avut ocazia să scoatem multă sucul ASUS ProArt P16, unul dintre primele dispozitive bazate pe acest dispozitiv Nvidia.
Avem multe de discutat. Să începem.
ARM așa cum nu am văzut niciodată ARM în Windows
Nvidia se uita cu degete la piața PC-urilor și laptopurilor de ani de zile cu o ambiție reînnoită. Nu i-a fost suficient să furnizeze plăcile grafice care au cucerit de ani de zile piața jocurilor: își dorea ceva mai mult. A vrut să ofere propriul său SoC pentru a începe o nouă eră a laptopurilor Windows bazate pe cipurile sale cu arhitectură ARM.
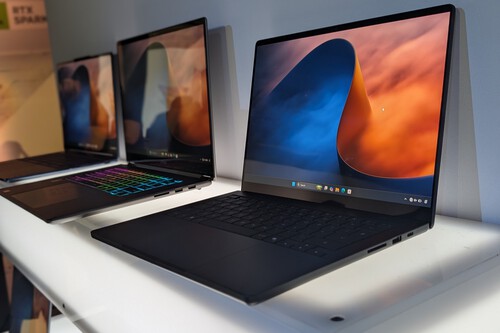
Nu este primul care îl încearcă —bună ziua, Qualcomm—, dar este cel care cu siguranță acoperă această sarcină cu un obiectiv clar: în timp ce încercările anterioare păreau să încerce să ne convingă de validitatea arhitecturii ARM datorită eficienței și performanței sale pe watt, aici Nvidia nu se încurcă: aceste cipuri sunt mai presus de toate, dar sunt relativ eficiente.
Fișa tehnică ASUS ProArt P16 (H7607)
ASUS ProArt P16 (H7607, RTX Spark)
Afișare
OLED 16" UHD+ (3.840 x 2.400) / 3K (2.880 x 1.800)
16:10, 120 Hz, 700/500 nits (standard), 1.600/1.100 nits (vârf)
Procesor
Nvidia RTX Spark N1X cu procesor cu 20 de nuclee
Nvidia RTX Spark N1X cu procesor cu 18 nuclee
Grafica
Nvidia Blackwell RTX cu 6.144 de nuclee
Nvidia Blackwell RTX cu 5.120 de nuclee
Memorie
24 / 32 / 48 / 64 / 128 GB memorie unificată LPDDR5X
Până la 300 GB/s lățime de bandă
Depozitare
SSD NVMe PCIe 4.0 de 512 GB / 1 TB / 2 TB
Slot de expansiune
2 x M.2 2280 PCIe 5.0x4
Porturi
3 x USB-C (USB 4.0 Gen 3, 40 Gbps)
1 x USB-A (USB 3.2 Gen 2, 10 Gbps)
1 x 3,5 mm
1 x HDMI 2.1
Cititor SD Express 7.0
Tastatură și touchpad
Tastatură cu iluminare din spate (cursă de 1,7 mm)
Tactil tactil haptic
Cameră web
Camera Full HD
IR cu suport Windows Hello
Conectivitate
Wi-Fi 7, Bluetooth 5.4
Baterie
99,9 WHrs
Adaptor de 140 W, cablu USB-C (240 W) inclus
Dimensiuni și greutate
354,1 x 243 x 12,9-15,9 mm
1,77 kg
Sistem de operare
Windows 11 Acasă / Pro
Preț
ProArt P16 (H7607)
Un design elegant și, mai presus de toate, puternic
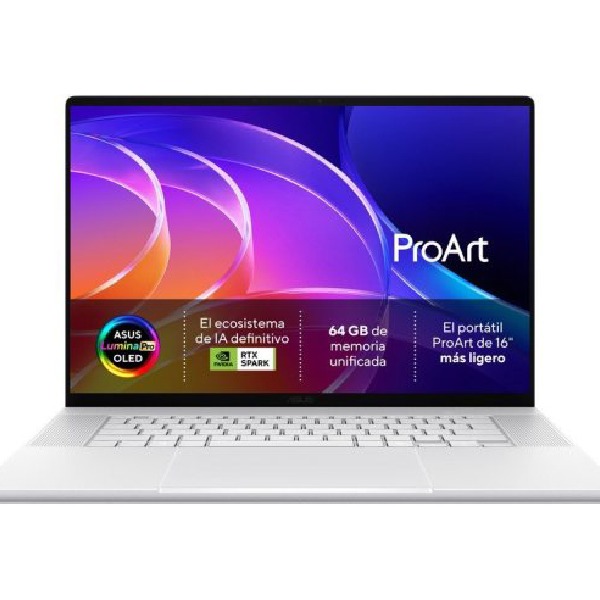
ASUS ProArt P16 (H7607BA) este unul dintre primele dispozitive care oferă aceste cipuri și, de asemenea, o fac însoțite de o configurație notabilă, mai ales pentru cei de până la 128 GB de „memorie unificată” LPDDR5X care sunt cheia pentru a putea încărca modele mari de AI locale.
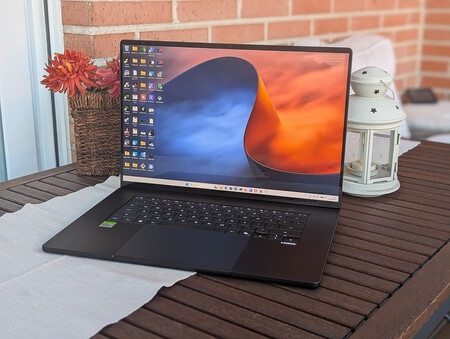
Cu toate acestea, am testat computerul negru care are RTX Spark în versiunea sa cu procesor cu 20 de nuclee, GPU cu 6.144 de nuclee, 64 GB și ecran OLED 3K.
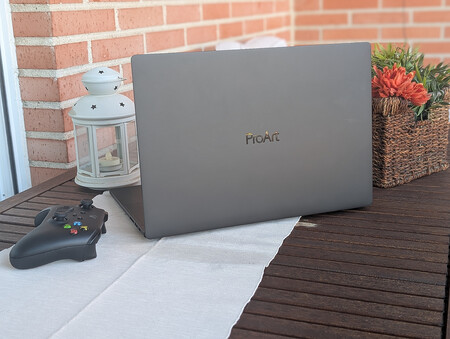
Ne uităm la un laptop cu finisaje atente, sobre și elegante. Aici nu există stridență și ceea ce este surprinzător este o subțire care după teste a părut chiar exagerată.
Iar acele 15,9 mm grosime în partea cea mai „volumentă” sunt o minune a miniaturizării, dar, după cum vom vedea mai târziu, poate că n-ar fi stricat să acordăm un pic mai multă marjă răcirii unui dispozitiv care atunci când se pune cu adevărat la treabă nu are prea mult spațiu pentru a lăsa căldura generată de aceste componente să scape.
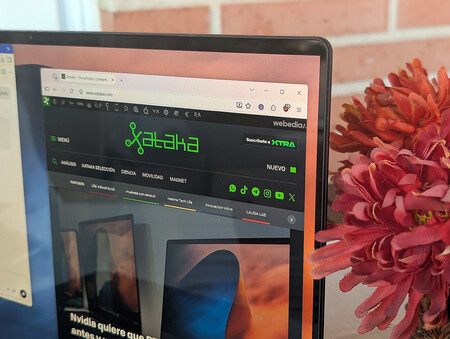
Fie oricum, a avea un dispozitiv cu ecran de 16 inchi și aceste dimensiuni este un lux: greutatea sa de 1,77 kg îl face un laptop dens și puternic. Una care nu înșală și care arată din prima clipă că este concepută pentru utilizatorii ambițioși.
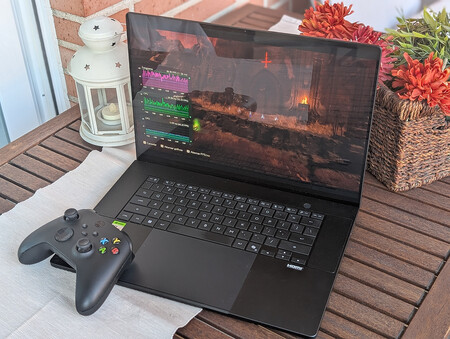
Ecranul OLED de 16 inchi are un finisaj lucios, iar calitatea lui este remarcabilă: avem panoul 3K, iar în această configurație culorile și contrastul sunt de invidiat. Calitatea și rezoluția imaginii fac să lucreze cu echipamentele din secțiunea vizuală o bucurie, dar este și posibil să stoarceți acel ecran cu conținut video cu care panoul iese clar.
Ne confruntăm și cu un panou cu suport multitouch în care putem folosi chiar și un stylus, dar atenție. Ecranul nu se pliază complet și nu ne uităm la o decapotabilă. Cu toate acestea, asistența este mai mult decât binevenită, iar ASUS se completează cu o rată de reîmprospătare de 120 Hz și o cameră web FHD cu suport Windows Hello.
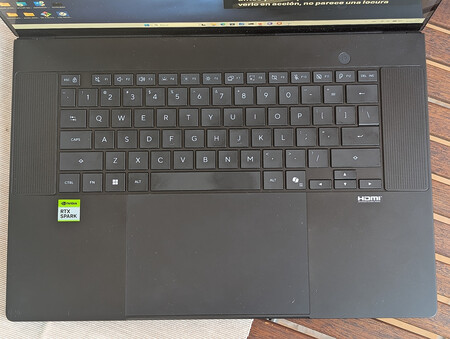
Tastatura este fantastică: atingerea și deplasarea tastelor sunt excelente și nu am avut probleme să ne obișnuim rapid cu aspectul ANSI din SUA, deși aici există câteva sacrificii tradiționale, cum ar fi tastele cursor care sunt jumătate din restul tastelor normale pentru a le păstra în acel rând inferior al tastaturii.
Între timp, touchpad-ul cu tehnologie haptică urmează acea tendință pe care am văzut-o și am îmbrățișat-o în ultima vreme în aceste componente: este uriaș și ocupă practic jumătate din ceea ce ocupă tastatura. Suportul pentru atingere și gesturi este fantastic și răspunsul haptic menționat mai sus se comportă perfect.
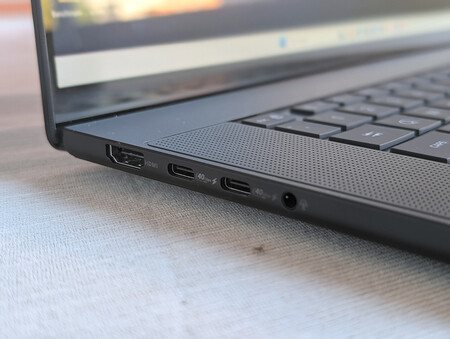
Porturile disponibile sunt conforme: avem trei porturi USB-C (USB4) și chiar un port USB-A, iar acestora li se alătură portul HDMI 2.1, portul pentru căști și chiar un cititor de carduri SD. Poate unora le lipsește un port Ethernet, dar având în vedere grosimea echipamentului, integrarea acestuia a fost complicată.
Conectivitatea wireless este, de asemenea, foarte bine acoperită cu suportul Wi-Fi 7 și Bluetooth 5.4. În ceea ce privește încărcarea, dispozitivul include un adaptor (surprinzător) mic de 140 W și un cablu USB-C pe care îl putem folosi în oricare dintre porturile de acest tip pe care le avem pe dispozitiv.
Cipul promite, „memoria unificată” promite mai mult
Cu toate acestea, protagonistul absolut al echipei este SoC-ul creat de Nvidia și MediaTek,182, un procesor N1 și MediaTek,182, un CPU N1 și un nucleu MediaTek. GPU cu arhitectură Blackwell (la fel ca RTX 50) cu 5.120/6.144 de nuclee.
În testele noastre, procesorul RTX Spark a obținut 540 de puncte în single-core și 6.855 de puncte în multicore în Cinebench 2026. Între timp, Geekbench 7 a arătat 2.522 și, respectiv, 21.774 de puncte în acele configurații. Pentru a ne face o idee, ne uităm la un SoC care concurează în mod clar cu M4 Pro care, de exemplu, obține 3.375 de puncte în single-core și 24.890 de puncte în multi-core în Geekbench 7.
Cifrele arată că avem de-a face cu un procesor mai mult decât decent, dar nu strălucește spectaculos în sarcinile cu un singur fir. Cipul câștigă numere întregi în multithreading, unde, după cum vedem, este aproape de acel M4 Pro și aici se observă că Apple continuă să-și marcheze puterea în ARM.

De fapt, M4 Pro și M4 Max au fost prezentate în octombrie 2024; GB10 care stă la baza N1X a făcut-o în octombrie 2025. Vestea bună? Acesta este doar începutul drumului pentru Nvidia și, fără îndoială, performanța SoC-urilor sale ARM se va îmbunătăți în generațiile viitoare.
Cealaltă parte integrantă a acestui pariu este "memoria unificată" (același termen pe care Apple îl folosește de ani de zile) care include acest echipament și Cu aplicația Nvidia avem o modalitate simplă de a „redistribui” alocarea memoriei către GPU. Pe computerele de 64 GB putem aloca până la 48 GB procesorului grafic.
Este posibil să se schimbe cu ușurință alocarea memoriei din aplicația Nvidia: în secțiunea Sistem->Avansat vom vedea cum putem ajunge la până la 48 GB alocați GPU-ului ca maxim pe acest computer, ceea ce lasă 16 GB de memorie pentru sistemul de operare și aplicații.
Jucatul cu aceste setări oferă puțin mai multă libertate de a încărca modelele AI cu o fereastră de context mai mare și este o modalitate ușoară de a profita la maximum de această resursă. Fiecare modificare, totuși, va necesita o repornire a mașinii pentru ca aceasta să fie aplicată.
Folosirea AI locală ca și cum n-ar fi existat mâine
Deși echipa se descurcă foarte bine în toate domeniile, există un domeniu în care strălucește într-un mod special. Și zona respectivă este, desigur, rularea modelelor locale de AI. Acei 64 GB de memorie unificată și GPU-ul remarcabil al SoC-ului N1X dau mult joc aici, iar din prima clipă am vrut să știm la ce ne putem aștepta de la acest echipament.
Pentru a face acest lucru, am rulat o baterie de teste recomandate de Nvidia și care ne-au permis să demonstrăm că viteza de decodare (generarea de token) cu modelul popular Qwen3.8-27B a fost mai mult decât decentă în acele teste.
Testați
Qwen3.8-27B (UD-Q4_K_M) cu DFlash 2
Speedbench, decodare (jetoane/S)
27,22
AgentPerf Local, decriptare (jetoane/e)
35,96
AgentPerf Local, timp normalizat(e)
1.052,33
16k context: primul simbol(e)
22.57
Context de 16.000: de la capăt la capăt
66,76
Context de 32.000: primul simbol(e)
51.23
Context de 32.000: de la capăt la capăt
100,95
Context de 64.000: primul simbol(e)
104.48
Context 64K: de la capăt la capăt
161,54
Trebuie remarcat că timpul până la primul token este mai lung, cu atât contextul este mai larg: atunci când introducem prompturi cu 64.000 de jetoane de intrare, trebuie să așteptăm aproximativ 104 secunde pentru ca respectiva intrare să fie procesată și calculată, iar decodarea scade la aproximativ 18 jetoane pe secundă: acesta este costul procesării acestor solicitări, vom observa că dispozitivul va folosi ceva timp în care GPU-ul este integrat, dacă vom folosi GPU îndelung. documente.
Efectuăm alte teste sintetice binecunoscute în acest segment, cum ar fi cele aparținând Clientului MLPerf. Acolo, analistul de date agentic i-a luat 62,6 s pentru a finaliza sarcina, iar agentul SWE (programare) a făcut-o în 96,1 s, în acest caz cu Qwen3.8-8B cu llama.CPP și CUDA.
De asemenea, am dorit să evaluăm comportamentul LM Studio cu o variantă mică de Qwen3.8: în special adăugând această versiune cu atenție și speculativă Qwen3.8. îmbunătățește calitatea răspunsurilor.
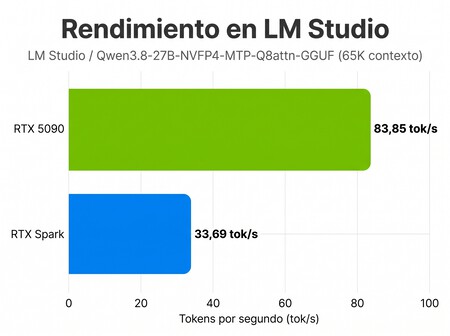
În ASUS ProArt P16 am dat ca exemplu promptul „generează un text de 1.000 de cuvinte despre evoluția Nvidia de la naștere”. Am primit un text foarte decent generat la 33,69 de jetoane pe secundă, o cifră spectaculoasă pentru un laptop.
În testele noastre cu un PC cu un Core i5-13400 și un RTX 5090 cu Windows 11 și aceeași aplicație (LM Studio) și model, viteza respectivă a fost de 83,85 jetoane/s. Având în vedere că RTX 5090 este o adevărată bestie, faptul că RTX Spark Soc generează răspunsuri la 40% din acea viteză este surprinzător și un semn foarte bun.
Alăturați-vă Xtra și întrebați direct experții noștri.
 LM Studio rulează Qwen3.8 pe ASUS ProArt P16
Această abilitate de a utiliza modele locale de AI se aplică și în domeniul creativ: aici testele cu ComfyUI și modele precum Flux2 au arătat că este posibil să se genereze imagini (sau videoclipuri cu alte modele precum Minimax H3) cu o calitate fantastică.
 Rezultatele testelor cu ComyUI, V-ray și Blender comparând datele obținute și diferența cu rezultatele interne ale Nvidia.
Este adevărat că timpii de aici sunt mai lungi în comparație cu modelele cloud, dar din nou acea capacitate de a nu depinde de modelele menționate, de a le generare „gratuit” (fără a lua în calcul prețul echipamentului și cheltuielile de energie, desigur) și de a păstra acele sesiuni private este foarte interesantă.
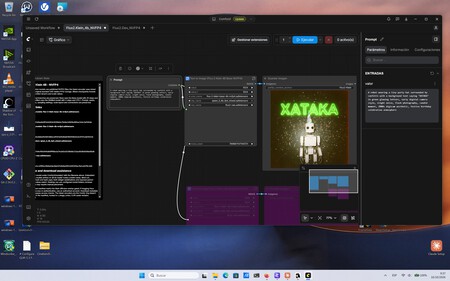 ComfyUI este o opțiune excelentă pentru generarea de imagini și videoclipuri cu toate tipurile de modele destinate domeniului creativ, iar pe acest dispozitiv funcționează foarte, foarte bine.
Toate aceste cifre ne vorbesc despre performanțe promițătoare, dar unde observați cu adevărat magia unei „fabricii de jetoane” este atunci când lucrați cu agenți AI de programare c precum OpenCode sau, direct, faceți ceva despre care Nvidia a vorbit mult la RTX Spark Day: folosirea agenților AI precum OpenClaw, Hermes sau Perplexity.
Uite mamă, laptopul meu este o fabrică de simboluri
Am vrut să ne facem testele cu Hermes, un proiect care a câștigat multe puncte în ultimele luni pentru capacitatea sa de a auto-învăța și de a-și actualiza abilitățile care îl fac pe Hermes „mai inteligent” în fiecare zi dacă acționăm ca educatori diligenti.
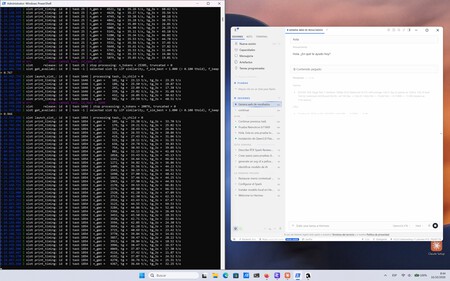 Modelul Qwen3.8 rulează cu jurnalul care arată activitatea în stânga, Hermes gândindu-se la sarcina pe care i-am cerut-o în dreapta.
Instalarea Hermes este ușoară pe aceste computere RTX Spark, deoarece un expert binevenit ne oferă tocmai alegerea pe care vrem să îl instalăm în Windows 11 și procesul se face în doar câteva minute: procesele oarecum greoaie pe care OpenClaw le-a propus, de exemplu, au rămas în trecut.
Aceasta face mai ușor pentru orice utilizator să experimenteze cu un proiect care îndeplinește marea promisiune a AI: a face lucruri pentru tine. Hermes poate deveni un asistent dedicat de la care putem cere totul și care va fi mai util cu cât are mai mult acces la viața noastră. Am vorbit adesea despre cum Muse sau Instinct sunt minunate până când te gândești puțin la modul în care îți expun intimitatea.
Ei bine, cu Hermes folosind modele locale, avem ce este mai bun din ambele lumi: o mașină care face lucruri pentru noi, dar care nu este bârfă: teoretic toate conversațiile și datele noastre rămân pe computer și nu pleacă de acolo, lucru care este, fără îndoială, liniștitor.
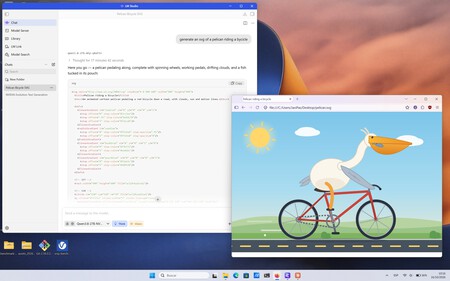 Renumitul test de creare a unui SVG al unui pelican care merge pe bicicletă (creat de Simon Willinson) este rezolvat într-un mod de invidiat în Qwen3.8 prin LM Studio.
Aici trebuie să ținem cont de faptul că această confidențialitate depinde de configurația agentului, de instrumentele și conexiunile acestuia și de telemetria acestor aplicații: pot exista metadate care sunt trimise către serverele anumitor instrumente (și dacă căutăm pe Google, va exista în continuare o colectare a acestor solicitări de căutare, desigur), dar angajamentul este mult mai limitat decât în cazul modelelor cloud.
Dar așa cum am spus, utilizarea modelelor locale pe aceste computere ne oferă jetoane infinite și, mai presus de toate, „gratuit”. Este „gratuit” cu multe ghilimele, pentru că pentru a te putea bucura de toate acele jetoane investiția inițială a fost cu adevărat puternică. Chiar și așa, dacă suntem utilizatori intensivi de modele AI, a avea la dispoziție posibilitatea de a ne bucura de modele decente care rulează local este extrem de interesant.
 Qwen3.8-27B este un model uimitor și aproape la fel de bun ca Claude Opus 4.7, care nu cu mult timp în urmă era unul dintre cele mai bune modele AI (în cloud!) de pe piață.
Mai ales când vedem cum au evoluat aceste modele. Este adevărat că nu pot concura cu cele mai bune modele de frontieră, dar aveți grijă, pentru că nu sunt atât de departe de ceea ce în urmă cu câteva luni era considerat un model de frontieră. Qwen3.8-27B are în Artificial Analysis un „indice de inteligență” de 34 de puncte, nu e rău având în vedere că Claude Opus are 58... și că Claude Opus 4.7 Max a ajuns la 41.
Experiența noastră cu Hermes a fost mai mult decât decentă, cu viteze medii de aproximativ 20-25 de jetoane/s în diferite conversații, întotdeauna cu Qwen3.8-27B. Este o figură notabilă mai ales având în vedere că acesta este un model dens care își încarcă toți parametrii în memorie în loc să recurgă la filosofia Mixture-of-Experts a altor modele deschise.
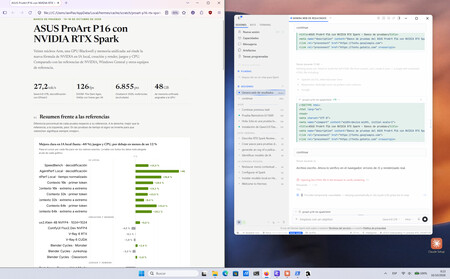 Site-ul web creat cu rezultatele testelor pe care le făceam a fost o modalitate excelentă de a pune acele date în perspectivă.
În utilizarea Hermes, de exemplu, am configurat un mic sistem pentru căutarea și selectarea subiectelor interesante pe care să le revizuim în fiecare dimineață: acel buletin de dimineață a apărut deja „curat” în e-mailul nostru într-un format HTML care poate fi citit și, împreună cu el, am avut un rezumat bun al celor mai importante știri ale zilei de îndată ce ne-am trezit.
Hermes este capabil să rezolve și nevoi privind proiectele software: în cazul nostru am creat o pagină web în care am compilat rezultatele testelor și benchmark-urilor efectuate pe echipamente pentru a le putea consulta cu ușurință, de exemplu.
De fapt, Hermes m-a ajutat să automatizez unele dintre aceste teste datorită unei „aptitudini” în format Markdown (.md) oferită de Nvidia. Agentul cere permisiunea atunci când are nevoie (și îi putem acorda permisiuni complete, deși asta poate fi riscant și preferăm să nu o facem), dar este capabil să finalizeze o mare parte a lucrării în mod autonom, fără alte prelungiri.
Autonomie, temperaturi și zgomot: pufnește peste tot
Acest lucru îi permite să se comporte foarte bine în multe scenarii, dar impune o încărcare semnificativă asupra conversațiilor și computerul o observă: ventilatoarele încep să zguduie la maxim iar temperatura în zona superioară a tastaturii și, de asemenea, sub laptop crește într-un mod clar vizibil.
De fapt, acesta este unul dintre dezavantajele utilizării intensive a AI pe acest echipament: zgomotul este audibil și enervant, așa că fie avem echipamentul într-o altă cameră și îl controlăm de la distanță, fie va trebui să suportăm acel pufnit constant dacă continuăm să-l punem în probleme rulând modele locale de AI.
Inginerii Nvidia ne-au avertizat deja despre acest lucru în timpul RTX Spark Day, dar aceste dispozitive au un avantaj deosebit: cu greu își pierd performanța când le deconectăm de la curent: puterea de livrare este practic aceeași indiferent dacă le avem în încărcare constantă sau nu, lucru care nu este de obicei cazul, de exemplu, la multe alte laptopuri grafice
.
Acest ASUS ProArt P16 are o baterie de 99,9 Wh, o cifră fantastică care oferă mult spațiu pentru a lucra cu echipamentul pe o bază extinsă. Aici, însă, există o mare diferență de autonomie în funcție de ceea ce facem.
Astfel, în utilizarea standard a echipamentului pentru munca de birou și navigarea pe web am reușit cu ușurință să petrecem mai mult de 14 ore cu luminozitate medie și modul de performanță echilibrat. Totuși, dacă deconectam echipamentul de la curent și începem să rulăm modele AI locale (sau să jucăm jocuri), această autonomie se reduce foarte repede, așa că în aceste cazuri este indicat să avem laptopul conectat la curent.
Joaca pe un RTX Spark este grozav, dar DLSS are multe de spus
GPU-ul Blackwell al lui RTX Spark ne-a permis de asemenea să testăm acest ProArt P16 cu un alt domeniu în care promite să iasă în evidență: jocurile video. Înainte de a intra în ele, testele sintetice au lăsat două referințe: 2.981 de puncte în 3DMark Steel Nomad și 11.474 de puncte în Solar Bay Extreme.
Ambele teste servesc la evaluarea performanței sale de bază, deși experiența de joc depinde întotdeauna de setările alese și, în acest caz, de DLSS și generarea de cadre, care în acest caz oferă multe numere întregi.
În „DOOM: The Dark Ages” am obținut 126,31 FPS în medie în scena „Siege, Part 1” la 1440p, cu DLSS în modul Balanced și generarea de cadre 3X. Figura arată că fluiditatea vizuală pe ecranul de 120 Hz al dispozitivului este excelentă. Trebuie clarificat că o parte din aceste cadre sunt generate, deci nu jucăm la 126 FPS redate și nici același răspuns nu este garantat în comenzi. Cu toate acestea, experiența noastră jucând jocul normal a fost perfectă, fluidă și fără tăieturi sau conflicte/artefacte grafice.
În „Shadow of the Tomb Raider” avem o a doua referință cu jocul la 1440p, de înaltă calitate și DLSS echilibrat (nu există suport pentru generarea de cadre aici, de exemplu). În benchmark-ul său intern am obținut în medie 95 FPS, cu 72 de minime și 127 de maxime. Este un rezultat care lasă loc pentru a profita de panoul de 120 Hz al ASUS ProArt P16 în anumite momente și arată că capacitatea grafică a cipului nu poate fi dedicată doar rulării modelelor locale de AI, ci cu siguranță și acestei zone.
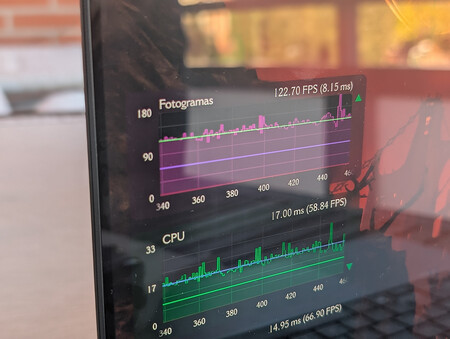
De fapt, impresia lăsată de aceste teste este că poți juca foarte bine pe ProArt P16 atâta timp cât anumite setări sunt acceptate. DLSS este important dacă vrem să jucăm la 1440p la calități înalte, iar generarea cadrelor poate ajuta foarte mult la fluiditatea percepută.
Dar și asta definește limita acestei propuneri de la Nvidia și producătorii care au adoptat RTX Spark. Aici cu siguranță avem posibilitatea de a juca fără probleme în rezoluții 1440p chiar și titluri pretențioase dacă facem niște concesii, dar laptopurile RTX Spark nu pot fi clasificate drept „laptop-uri de gaming pur”. Să ne amintim: cipul este aproape identic cu GB10 al lui DGX Spark de acum un an, iar accentul său continuă să fie execuția modelelor locale de AI.
ASUS ProArt P16 cu RTX Spark, opinia lui Serviciul Secret de Inteligență
ASUS ProArt P16 arată că există loc pentru o altă clasă de laptop Windows și că nu totul trebuie să fie mașini cu cipuri Intel sau AMD. Procesorul platformei RTX Spark satisface, dar nu uimește, ecranul și designul sunt remarcabile și la egalitate cu un dispozitiv premium, iar jocurile rulează mai bine decât v-ați aștepta de la un GPU integrat, deși DLSS are mult de-a face cu asta.
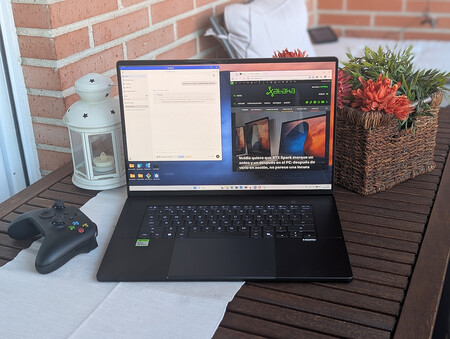
Adevăratul său motiv de a fi apare atunci când vrem să rulăm modele locale de AI: având CUDA și 64 GB de memorie partajată ne permite să lucrăm cu modele și contexte care pun în dificultate multe grafice de laptop dedicate, iar aici echipamentul strălucește cu propria lumină.
Acest avantaj, desigur, are condiții. ProArt P16 ne oferă toate avantajele unui computer portabil pe care îl putem duce oriunde, dar dacă ne jucăm sau folosim AI la viteză maximă (cu modul de performanță), computerul devine zgomotos și se încălzește vizibil. Este un angajament clar pentru un dispozitiv deloc ieftin și care nu este recomandat celor care doresc doar să joace, să editeze sau să facă interogări ocazionale către un chatbot: este greu de justificat valabilitatea acestuia.
Cu toate acestea, dacă ceea ce doriți este să experimentați cu modele AI locale de o anumită dimensiune pe laptop în orice moment și loc, avem în sfârșit o alternativă izbitoare la MacBook Pro. Unul care are și acel suport CUDA nativ care este atât de important în domeniul AI.
Prețurile ale versiunilor actuale sunt următoarele:
- ASUS ProArt P16 (CPU 18 nuclee, GPU 5.120 nuclee, 32 GB, 1 TB): 3.499,99 euro
- ASUS ProArt P16 (CPU 20 nuclee, GPU 6.144 nuclee, 48 GB, 1 TB): 3.499,99 euro
- ASUS ProArt P16 (CPU 20 nuclee, GPU 6.144 nuclee, 48 GB, 1 TB): P. (CPU 20 nuclee, GPU 6.144 nuclee, 64 GB, 1 TB): 4.499,90 euro (modelul testat de noi).
- ASUS ProArt P16 (CPU 20 nuclee, GPU 6.144 nuclee, 128 GB, 2 TB): 6.99div >
8,8
În favoarea
- SoC Nvidia/MediaTek N1X este solvent în CPU și mai ales versatil în ceea ce privește GPU, atât pentru jocuri, cât și (mai ales) pentru AI
- Memoria unificată de 64 GB vă permite să încărcați modele de dimensiuni bune și să efectuați inferențe la nivel local
- Construcția este sobră și impecabilă, iar acel ecran OLED 3K la 120 Hz este o adevărată minune
Împotriva
- Dacă folosim AI sau ne jucăm la maximum (mod performanță), ventilatoarele fac mult zgomot, iar computerul se încălzește vizibil
- Performanța procesorului nu este spectaculoasă, iar în jocuri, GPU-ul funcționează în special datorită suportului DLSS
- Prețul este mare, iar criza de memorie nu ajută dacă vrem să accesăm configurațiile de 64 sau 128 GB RAM
ProArt P16 (H7607)
Acest dispozitiv a fost furnizat pentru testare de către ASUS. Puteți consulta cum facem recenzii În investigația noastră tehnică și politica noastră privind relațiile cu companiile.